
AMIF · 回顾
AI + 音乐:赋能,而非主导
AMIF 2025 · 项目档案
来自节庆档案
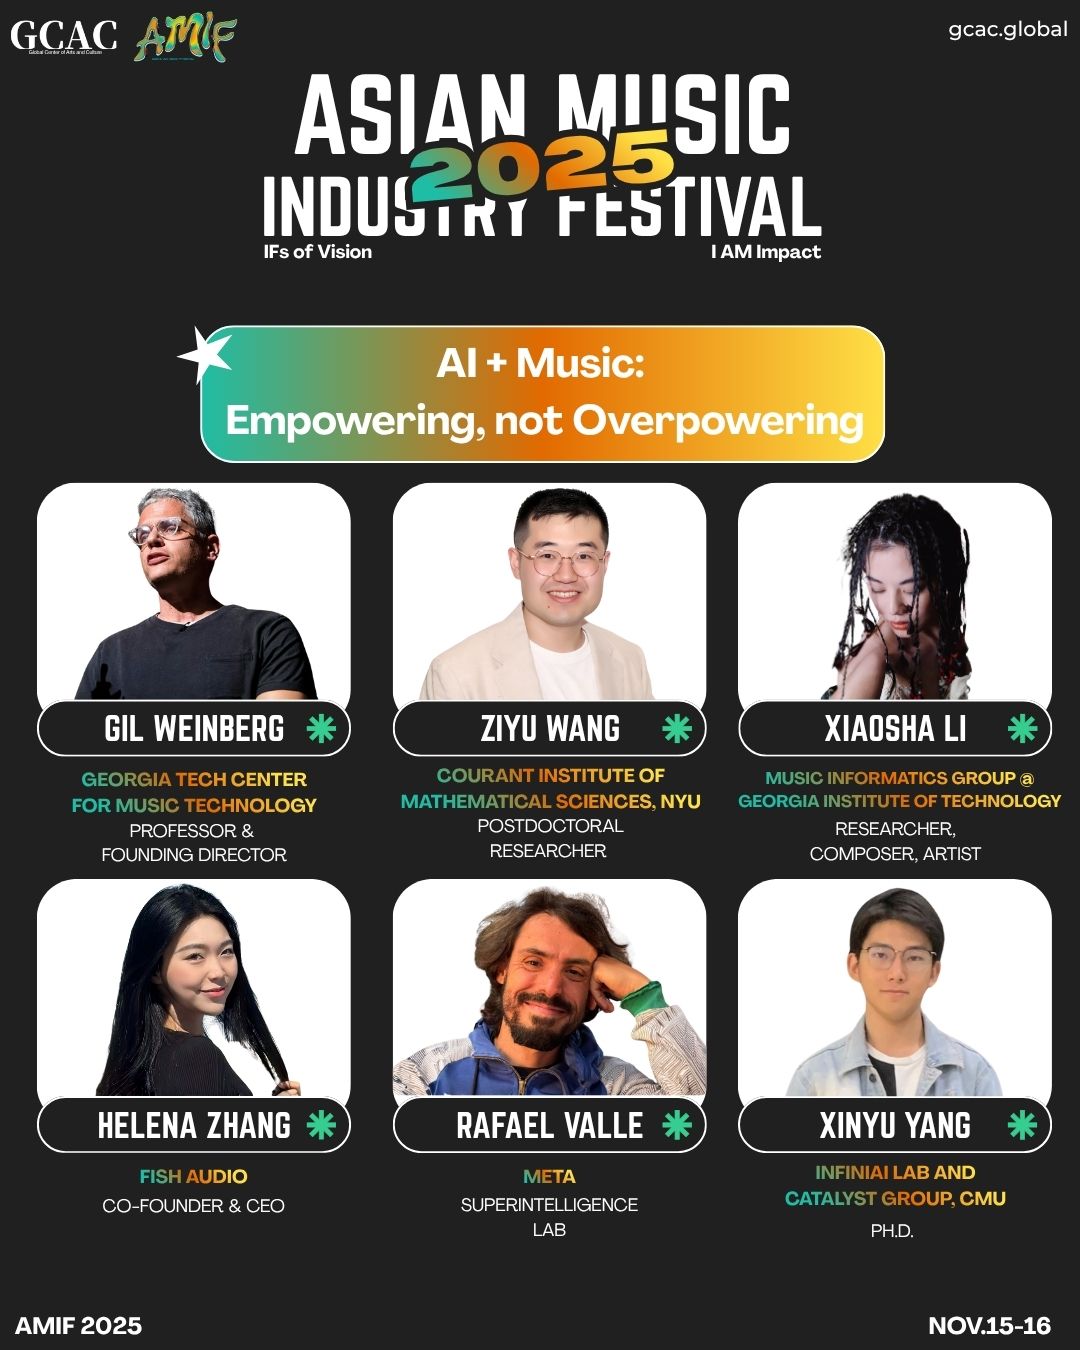
‘AI + 音乐:赋能,而非主导’探讨了音乐创作中人类表达与人工智能之间的平衡,汇聚了佐治亚理工学院、纽约大学、Meta、Fish Audio 以及卡内基梅隆大学的多元视角。
2025 年活动嘉宾及个人简介:
Gil Weinberg — 教授兼创始主任,佐治亚理工学院音乐技术中心
作为机器人音乐领域的先驱,韦因伯格通过融合人工智能、机器人技术与人类表达的项目,重新定义了创作与协作的边界。
Ziyu Wang — 博士后研究员,纽约大学科朗数学科学研究所
在扬·勒库恩教授的指导下,王开发出融合机器学习与音乐智能的音乐世界模型,将学术深度与艺术实践相融合。
Xiaosha (Evelyne) Li — 研究员/作曲家/艺术家,乔治亚理工学院音乐信息学小组
李的研究聚焦于音频表达与AI可解释性,连接了机器感知与音乐控制。她的作品在各大平台的播放量已突破70万次。
Helena Zhang — 联合创始人兼首席执行官,Fish Audio
在表达性语音生成领域处于领先地位,张的工作通过Fish Audio和OpenAudio拓展了文本转语音技术的情感与创造性边界。
Rafael Valle — 研究科学家,Meta超级智能实验室
曾任职于NVIDIA的生成式音频专家Valle,在多模态理解与AI即兴创作方面的研究,推动了机器创造力的边界。
Xinyu Yang — 博士研究生,InfiniAI实验室与Catalyst小组,CMU
可扩展基础模型系统研究员,亚马逊AI研究员,以及多个全球AI学术社区的创始人,致力于推动负责任人工智能的发展。
图片与短片 · @亚洲音乐产业节 · 2025-11-06
 观看
AI + 音乐 · 激发创作者潜能
‘AI与音乐:赋能而非主导’探讨了技术如何支持音乐创作,同时保护音乐人的创作自主性……
 观看
Wei Shan · 连接现场音乐文化
Wei Shan的AMIF 2025对话聚焦于如何根据不同文化背景调整现场演出,并实现……
 观看
Jae Chong · 一曲爆红背后的创作蓝图
Jae Chong 的 AMIF 2025 专场深入探讨了热门专辑的创作过程:制作团队如何跨领域协作……